Давайте я сразу обозначу, что каждый выбирает для себя и своих задач инструменты, которые ему удобны.
Если вашим задачам не подходят мои методы, значит, вы просто закрываете вкладку и идёте искать свой Грааль.
Договорились?Для начала: зачем вообще собирать собственный набор инструментов для биоинформатики, когда у нас уже есть научные агенты, на которых можно повесить почти весь пайплайн?
ЗАЧЕМ я его выложила?
Уж точно не в качестве предложения проделывать всю работу руками без делегирования агентам.
Не пристало пренебрегать благами цивилизации, облегчающими работу в десять раз:)
Мне хотелось вам показать, что находится под чатами и агентами. Причём, сразу отметив при этом важные вещи, которые рано или поздно вставят вам палки в колёса: где-что платно/бесплатно, что разрешает лицензия (можно ли использовать в коммерческих целях), какой доступ требуется. ВОТ, ЗАЧЕМ. Агент вам может собрать двадцать пять инструментов, и вы будете понимать, что из них каждый делает, и на каких условиях вы вообще имеете право ими пользоваться. Особенно если вам потом нужен отчёт для научной работы.
Я люблю контролировать стек и понимать инструментарий, хочу сама выбирать степень автоматизации и знать, где я упираюсь в лицензию или доступ. А ещё есть сэйфти, блокирующие запросы. И про них чуть ниже.
Иногда я могу реально предпочесть что-то сделать руками, чем отдать агенту; иногда хочу посадить сверху агента; иногда агент нужен чисто как оркестратор между несколькими тулзами. В общем-то, это не конкурирующие между собой режимы работы — всё зависит от задачи.А пока давайте возьмём следующую тему, которая и была здесь задумана.
АВТОМАТИЗАЦИЯ ХИМБИО ВОРКФЛОУ С ПОМОЩЬЮ ИИ.
Claude Science сразу вышибает дверь с ноги своим мощным общим агентом-координатором и более чем шестью десятками тулзов и коннекторов для геномики/протеомики, хемоинформатики и других страшных слов. Вполне настоящий научный воркбенч. Умеет помыкать Jupyter, R, удалёнными машинами и HPC, вызывать спец инструменты и оставлять историю проделанной работы.
Заявлено«Умеет порождать субагентов, работать с пользовательскими агентами, запускать расчёты локально, по SSH или на HPC, использовать внешние GPU через Modal, а отдельный reviewer-agent проверяет вычисления и ссылки. Результаты сохраняются вместе с кодом и историей происхождения, то есть их можно потом проверить и воспроизвести».
ДоступВходит в платные подписки Pro, Max, Team и Enterprise. Для расширенной работы с чувствительной биологией нужна верификация LSVP, пока для Team/Enterprise или API, индивидуальные планы добавятся позднее.
Сама пробовала только на Pro. В июле при обкатке модель раздавала алерты и закрывала сессии из-за специфичности запросов. Сейчас, думаю, ситуация стала значительно лучше.И Claude Science здесь далеко не один. Поле уже паханное!
У Google есть Gemini for Science и Science Skills: там агент тоже не лыком шит (к слову, я пользуюсь им) и уже связан более чем с тридцатью базами и инструментами на данный момент (смотрите, пожалуйста, дату публикации поста), включая UniProt, AlphaFold Database, AlphaGenome и InterPro.
Заявлено«UniProt, AlphaFold Database, AlphaGenome, InterPro, PubChem, ChEMBL, ClinVar, gnomAD и другими. Причём сам набор Science Skills опубликован открыто и устанавливается отдельно, а некоторые источники требуют собственного API-ключа или дают с ним более высокие лимиты».
ДоступЕсть бесплатный тариф, платные дают больше лимитов. Science Skills открыты на Гите; некоторым базам нужны свои API-ключи.
Бок о бок работают Co-Scientist для гипотез и инсайтов (большинство генераций посредственные), Computational Discovery для вычислительных экспериментов и Literature Insights (для литературы). Пока доступ постепенно раскатывается.
Перейдём к другому конгломерату: у Microsoft есть Discovery. Тут вам и агенты, и инструменты, даже база знаний своя, вычисления и оркестрация исследовательского цикла не хуже, чем у Антропиков + даю ссыль на GitHub Copilot
Заявлено«Может создавать собственных научных агентов, давать им knowledge base, модели и инструменты, а затем объединять их в multi-agent workflow. Shared session там уже означает исследовательскую сессию, внутри которой агенты проводят вычисления и анализируют данные. Существует локальный Discovery app для одного исследователя и полноценная облачная версия в Azure для команд, больших вычислений, приватных данных и корпоративного контроля».
AZUREДоступЛокальная приложуха бесплатная, использует лимиты Copilot и мощности вашего компьютера. Облачная версия работает через платный Azure.
Есть узкий smarts.bio, который специализируется именно на биоинформатике и уже умеет запускать десятки тулзов, собирая полноценные пайплайны. Интеграция тут.
Заявлено«В их облаке предустановлено больше 80 инструментов — GATK, STAR, SAMtools, BLAST, Boltz-2 и другие. Агент может запускать их сам, собирать анализ из нескольких стадий и работать с файлами. При этом smarts.bio подключается через MCP к Claude, ChatGPT, Gemini, Cursor, Windsurf, работает из VS Code, JupyterLab, CLI и через API».
ДоступБесплатно: 2 вычислительных часа, 1000 обращений к API и 10 ГБ в месяц. Дальше платные тарифы.
Есть локальный опенсорсный Wisp Science с Python, R, SSH и научными MCP. Ссыль на Гит.
Заявлено«Хранит проект и историю локально, запускает Python и R, работает с удалёнными машинами и GPU по SSH, умеет обращаться примерно к 80 научным базам и позволяет выбрать модель самостоятельно: Anthropic, OpenAI-совместимую или другой поддерживаемый backend. Здесь агент получает доступ к файлам, shell, вычислениям и scientific skills, но исследователь контролирует саму среду значительно сильнее».
ДоступБесплатный открытый проект (AGPL-3.0). Раздельно оплачиваются выбранная модель и вычисления, если они не локальные.
Есть FutureHouse / Edison / Kosmos с научными агентами. Откройте спойлер, посмотрите, как здорово для автономки. Но тут всё равно очень важен человек в цепочке и над системой. Потому что находятся статистически значимые, но глючные, бессмысленные закономерности. Так что требуется проверка результата.
Заявлено«Попытка сделать автономного AI scientist. У Edison есть отдельные агенты для литературы, поиска прецедентов и анализа данных; Edison Analysis итеративно строит и переписывает Jupyter notebooks, исследуя переданный dataset. Kosmos может самостоятельно искать публичные наборы данных, подтягивать их в исследование и вести гораздо более длинную цепочку анализа и проверки гипотез».
ДоступБазовые агенты дают 10 бесплатных кредитов в месяц. Kosmos пока распространяется постепенно, условия доступа и тарифы меняются.
Бери — не хочу.
Есть даже универсальные конструкторы.
Например, Hermes; его агент сам по себе не от мира биологии — просто агентная система, вот вам ссылочка на Гит. Хорошая система, надо сказать (память, код, файлы, браузер, субагенты и MCP и другое). Подключаете серверы, ставите тулзы, даёте доступ к данным и лепите собственного помощника под конкретную задачу.Заявлено«Универсальная агентная оболочка: терминал, файлы, выполнение кода, память, субагенты, автоматизация и полноценный MCP-клиент. Через MCP ему можно подключить базы, API и внешние инструменты, после чего он обнаружит их и сможет вызывать как собственные».
ДоступБесплатный открытый проект (MIT). Расходы только на внешнюю модель, API и облачные вычисления; с локальной моделью их можно избежать.
BioChatter делает почти то же самое в биомеде, дам ссыль на репозиторий тоже (вяжет модели с базами, API, пайтоном и графами). А вот с помощью тех же BioMCP или MCP серверов агент получает структурированные научные данные.
И последний по списку, но не по значимости — ̶п̶р̶и̶н̶ц̶е̶с̶с̶а̶ ̶Ф̶и̶о̶н̶а̶ ChatGPT. Наверное, даже не так. А вот в такой связке: Глубокий ресёрч + ChatGPT Work + Codex. Мой обычный воркфлоу.
Для ресёрча есть Deep Research — агентный режим, который сам строит многошаговый поиск и рыщет по вебу и подключённым источникам. Этот агент вполне себе справляется с анализом довольно больших текстов, спокойно парсит изображения и PDF, с файлами умеет работать и строить графики. По проделанной работе может выдавать отчёт с источниками. С февраля этого года Deep Research можно подрубать к MCP и приложениям и ограничивать поиск (то есть, выбираете доверенные источники и после этого запускаете).
ChatGPT Work — агент для длинных задач. Вот этот чел может вести проект часами, делать то же, что и глубокий ресёрч, вдобавок выполняет многошаговые действия и может подготовить вам и документ, и таблицу, и презентацию, и сайт, и всё остальное.
Codex умеет вести длинные задачи по коду, запускает несколько агентов параллельно и работает в облаке, спокойно справляется с файлами и тулзами, с ресёрчем, CLI, IDE и отдельном приложении. В общем, полноценная автоматизация воркфлоу даже для людей, которые вообще не разработчики:)
А вот буквально с сентября появился ещё есть Agents API: по сути, тот же агентный harness, который рулит всем и сразу контекст, тулзы, субагенты, если вам удобно, можно использовать для собственных облачных агентов с файлами/кодом и какими-то длительными задачами. Но это уже больше конструктор для разраба, чем научный воркбенч, конечно.Заявлено«Deep Research — многошаговый поиск и анализ источников; Work — длинные задачи через файлы, приложения, веб и инструменты с готовым артефактом на выходе; Codex — код, терминал, анализ данных, исследования и параллельные агенты. MCP и подключаемые приложения позволяют сверху пристегнуть специализированные источники и инструменты».
ДоступWork — платные планы, включая Plus, Pro, Business, Enterprise и Edu; Codex доступен во всех основных планах, включая Free/Go, но лимиты сильно различаются; Deep Research тоже зависит от тарифа и лимитов. На платных планах Work и Codex используют общий агентный объём/кредиты в зависимости от подписки.
Теперь пометка на полях.
Коннектор, агент и специализированный инструмент.
Учтите, что это разные штуковины.
Коннектор даёт модели способ обратиться к тулзу.
Агент решает, чего с ним делать, например, когда его вызвать и передать ему данные, или забрать результат и продолжить ресёрч. А сам расчёт всё равно выполняют BLAST, GATK, Boltz, софт по докингу, статистическая библиотека, в общем, всё, что вы туда подключили.
У каждого инструмента остаются ограничения (!) в виде тех же лицензий и доступа, API-ключей и квот, иногда вообще академическая регистрация нужна, и повезёт, если ваш универ входит в белый список.
Коннектор к Boltz лицензию на Boltz вам переписать не смогут, к сожалению, да и учётку на закрытом ресурсе не сделает. Агент вам лишних GPU не прикрутит.
Есть ещё одна причина, о которой забывают те, кто не работают с патогенами и токсичностью: между LLM и подключённым к ней научным стеком лежит куча сэйфти. Алерты могут сработать по любому, даже совершенно легитимному поводу.
Так что наличие шестидесяти коннекторов всеми любимому Claude разрешения на выполнение шестидесяти произвольных действий не даёт.
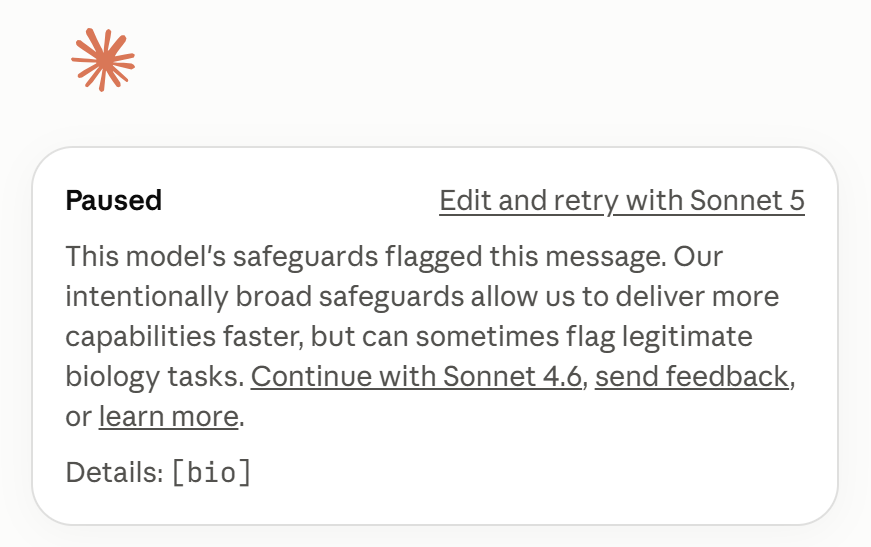
На скриншоте ниже — как раз этот баннер.
Запрос остановлен отдельным биологическим классификатором. А-та-та-баннер или тег [bio] совершенно необязательно выскакивает при каком-либо нарушении со стороны пользователя или алярм-запросе. Антропики немного поумерили сэйфти и сделали их более спокойными, но широкие биологические сэйфти могут цеплять био-ресёрч всё равно. В этом сентябре компания даже открыла Life Sciences Verification Program, где проверенным ресёрчерам дают модели с более разрешающими био-классификаторами для работ, которые в обычном доступе иногда блокируются; распространяется это в том числе на Claude Science. Для ресёрчей с ещё более высоким риском есть ещё более строгий уровень допуска.ChatGPT у нас иной (другая архитектура, инфра), но эффект сэйфти пользователь может увидеть очень похожий.
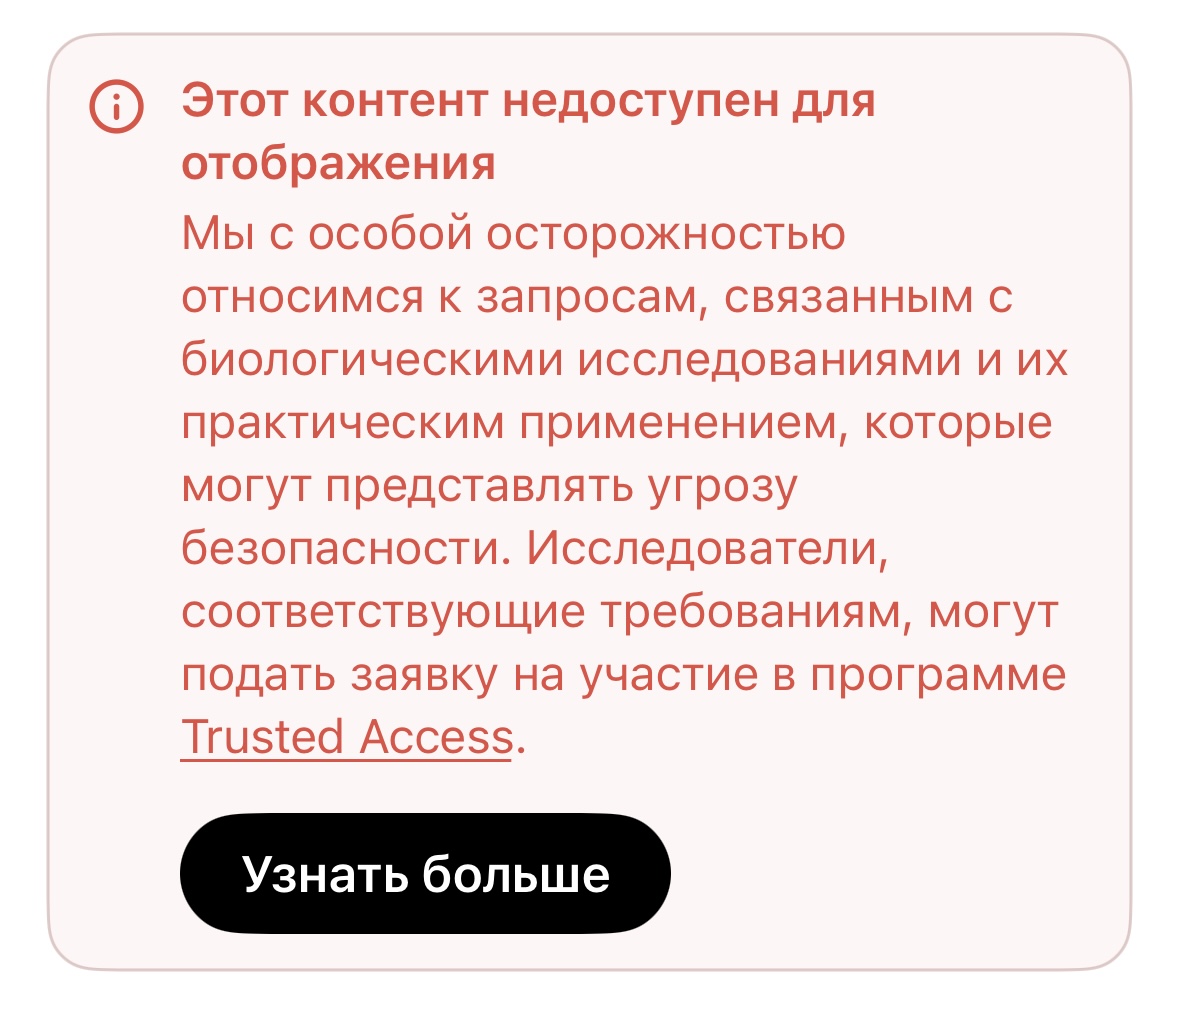
Запросы по химбио могут проходить дополнительные автоматические проверки; после такой проверки ответ может продолжиться, а может вообще не быть показан. Не знаю, как у вас, но мой GPT лояльный и сам помогает исправить промпты, чтобы уберечь модель от ложных срабатываний.
Появление такой проверки тоже не означает, что пользователь нарушил правила и что он био-террорист. Просто так совпало:)
Кстати, GPT-5.6 при всём этом безобразии обладает «высоким потенциалом в области биологических и химических рисков», так что вокруг него развернут многослойный стек с сэйфти поверх обычного поведения модели. Очень жаль, что нет доступа к Rosalind.:(Обсуждать в обычной работе можно. А вот когда система подозревает запрос, собирающий из сведений применимую процедуру в реале (реагирует на контексты, где появляются операционные параметры: доза, концентрация, способ получения или условия применения, dual use, токсичность, летальность, нестабильность, про-молекулы и так далее), короче, всё, что повышает воспроизводимость потенциально опасной работы, тут-то мы и получаем плашку блока.
Классификатор видит контекст целиком. Если операционные детали постепенно появились в том же диалоге, то и следующий невинный вопрос уже попадает под дополнительную проверку => ложные срабатывания: классификатору приходится отличать экспериментальную биологию от того же dual-use сценария.Так что мы либо пробиваем LLM новыми промптами (уточняем формулировку, убирая двусмысленность), стараясь исключить триггеры, либо возвращаемся в собственный стек и делаем то же самое собственноручно. :)
И если агент однажды вместо результата показывает вам большую красивую табличку [bio], очень здорово иметь возможность продолжить работу без ложных ограничителей. К слову, всегда есть и другая агентная среда для кросс-проверок, если лениво задействовать руки.